Braucht Innovation offene Daten? Ja. Braucht sie Datensouveränität? Ebenfalls ja.
Datensouveränität bedeutet, jederzeit selbstbestimmt
entscheiden und kontrollieren zu können, wie, von wem und zu welchem Zweck die
eigenen Daten genutzt werden.
Während Künstliche Intelligenz, Benchmarks und datengetriebene Geschäftsmodelle
immer größere Datenmengen benötigen, wachsen gleichzeitig die Anforderungen an
Datenschutz, Transparenz und Kontrolle. Stehen sich Innovation und
Datensouveränität damit zwangsläufig im Weg?
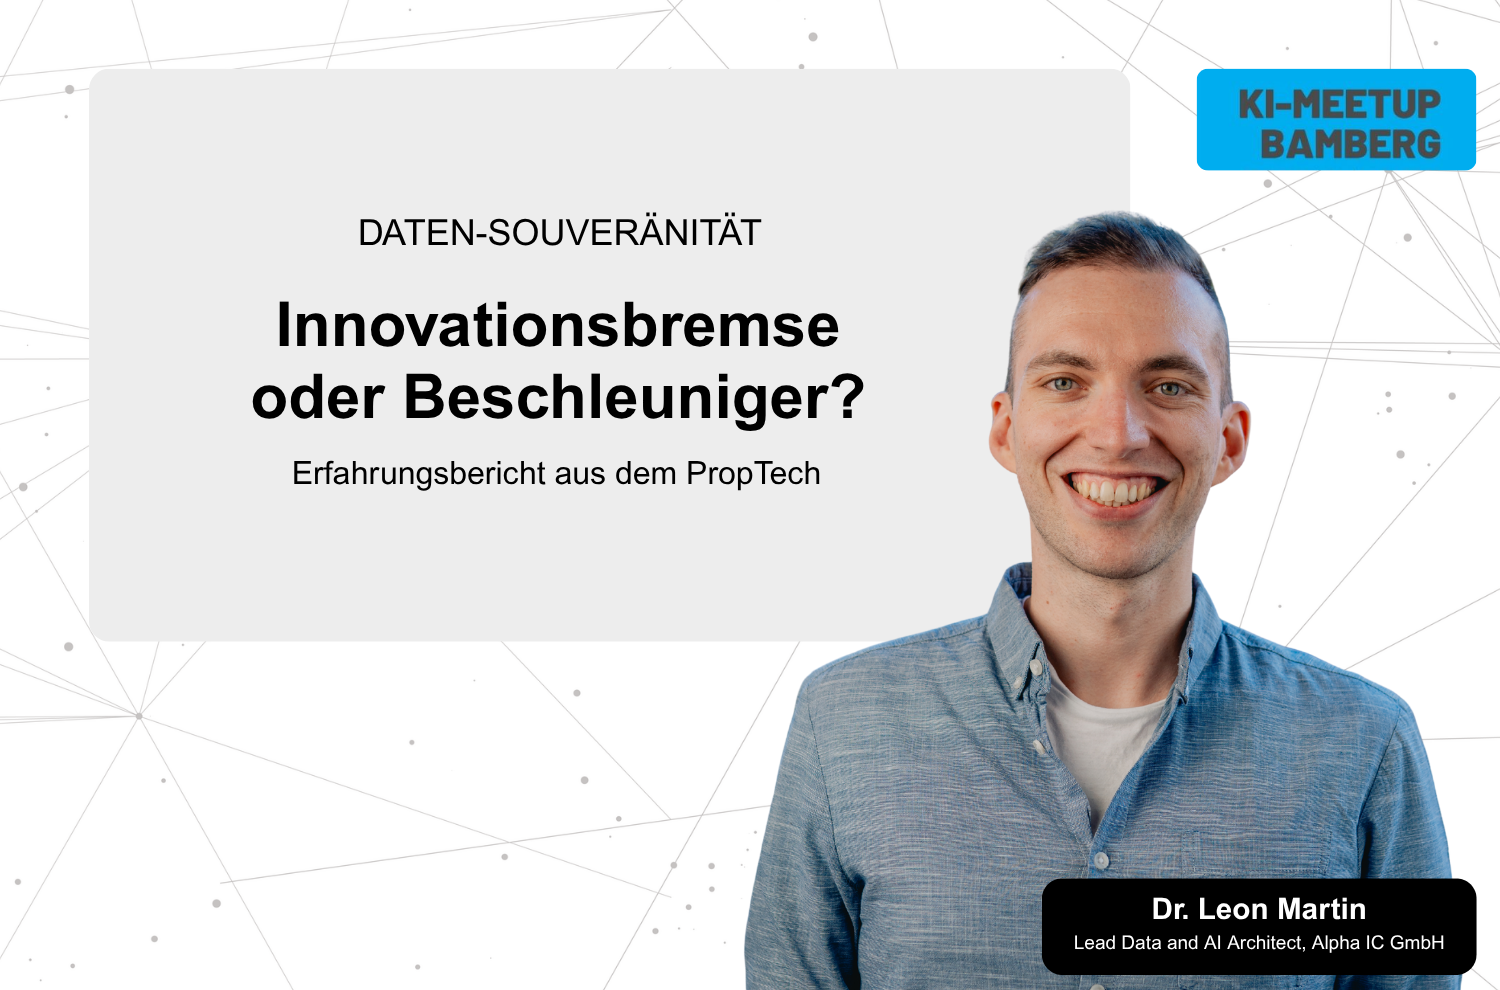
In seinem Vortrag „Datensouveränität: Innovationsbremse oder Beschleuniger?“ zeigte Leon Martin, warum Unternehmen nicht zwischen beidem wählen müssen und weshalb Datensouveränität Innovation nicht ausbremst, sondern überhaupt erst verlässlich ermöglicht.
Hier gelangen Sie zu unserem Produktfeld Digitalisierung.
Lesen Sie hier eine Zusammenfassung des Vortrags zur Datensouveränität: ⬇️
Müssen wir uns zwischen Innovation und Datensouveränität entscheiden?
Ausgangspunkt der Überlegungen waren die Erfahrungen von Alpha IC aus 25 Jahren Beratung in der Immobilienwirtschaft sowie die Arbeit mit der SaaS-Plattform Serthoro, über die heute zahlreiche Immobilienportfolios gesteuert werden.
Dabei zeigt sich immer wieder ein grundlegendes Prinzip:
Innovation beschränkt sich nicht auf neue Technologien. Sie entsteht auch, wenn verknüpfte Daten neue Erkenntnisse über Kosten, Prozesse oder Gebäude ermöglichen und Optimierungspotenziale sichtbar machen.
Gleichzeitig wächst mit der Bedeutung von Daten auch das Bedürfnis, die Kontrolle über sie zu behalten. Mit Big Data, KI und datengetriebenen Geschäftsmodellen gewinnen Fragen nach Schutz, Verantwortlichkeiten und Nutzungsrechten an Bedeutung.
Genau hier entsteht das vermeintliche Dilemma: Wenn Innovation Datenaustausch benötigt, Datensouveränität aber den Wunsch nach Kontrolle stärkt, blockieren sich beide Ziele dann nicht gegenseitig?
An dieser Stelle griff der Vortrag zwei konkrete Beispiele aus der Praxis auf:
Beispiel 1: Preis-Benchmarks für Immobilienportfolios
Ein häufiges Szenario in der Immobilienwirtschaft: Ein Eigentümer übernimmt ein Portfolio mit dutzenden Gebäuden und verfügt nur über wenige Informationen. Vielleicht sind Adresse und Nutzungsart bekannt. Doch Fragen wie diese bleiben oft offen:
- Welche Dienstleistungen werden erbracht?
- Wie hoch sind marktübliche Bewirtschaftungskosten?
- Welche Kosten sind angemessen?
- Wo existieren Einsparpotenziale?
Um solche Fragen beantworten zu können, werden belastbare Benchmarks benötigt. Diese entstehen jedoch nur dann, wenn Kosten-, Leistungs- und Gebäudedaten aus vielen Projekten und Portfolios aggregiert werden.
Innovation entsteht hier durch die Verknüpfung bislang getrennter Datenbestände. So lassen sich Betriebskosten besser einordnen und konkrete Optimierungspotenziale erkennen. Je mehr Beteiligte geeignete Daten unter klar definierten Bedingungen, desto präziser und aussagekräftiger werden die Vergleichswerte. Werden Daten dagegen grundsätzlich zurückgehalten, können aussagekräftige Benchmarks gar nicht erst entstehen.
Beispiel 2: KI für technische Dokumentation
Ein weiteres Beispiel stammt aus einem Forschungsprojekt zur automatisierten Verarbeitung technischer Wartungs- und Bestandsdokumentationen.
In der Praxis existieren für Gebäude oft enorme Mengen an Dokumenten:
- Wartungsanweisungen
- Herstellerunterlagen
- Prüfberichte
- Bestandsdokumentationen
- Betreiberinformationen
Diese Informationen liegen häufig in unterschiedlichen Formaten vor und wachsen über Jahre oder Jahrzehnte an.
Die Idee des Forschungsprojekts: KI soll diese Dokumente automatisiert analysieren, strukturieren und in standardisierte Datenmodelle überführen. Dadurch könnten Auditoren, Betreiber und Facility-Management-Teams deutlich schneller die Informationen erhalten, die sie für ihre Arbeit benötigen.
Doch auch hier gilt: Leistungsfähige KI benötigt Trainingsdaten.
Wenn Unternehmen aufgrund fehlender Transparenz, unklarer Verantwortlichkeiten oder Unsicherheit über Nutzungsrechte keine Daten bereitstellen können, wird auch die Entwicklung solcher Lösungen erschwert. Sind dagegen Nutzungsrechte, Verantwortlichkeiten und Rahmenbedingungen klar geregelt, können geeignete Daten gezielt und kontrolliert für solche Anwendungen bereitgestellt werden.
Datensouveränität bedeutet nicht, Daten grundsätzlich einzusperren.
Datensouveränität bedeutet zu wissen:
- Welche Daten vorhanden sind
- Wo sie liegen
- Wem sie gehören
- Wer Verantwortung trägt
- Unter welchen Bedingungen sie genutzt werden dürfen
Erst wenn diese Fragen beantwortet sind, können Organisationen bewusst entscheiden, welche Daten geteilt, geschützt oder für Innovationen genutzt werden.
Datensouveränität beseitigt die Unsicherheit, die Datenaustausch häufig verhindert.
Datensouveränität ist damit kein Gegenspieler von Innovation. Sie schafft die Voraussetzungen dafür, Daten kontrolliert und verantwortungsvoll für neue Anwendungen zu nutzen.
➡️ Oder in einem Satz: Die entscheidende Frage lautet nicht „Innovation oder Datensouveränität?“, sondern „Wie schaffen wir Innovation durch Datensouveränität?“
Sie möchten Daten sicher nutzen und gleichzeitig neue Anwendungsmöglichkeiten erschließen?
🗨️ Gerne tauschen wir uns mit Ihnen darüber aus, wie sich Datensouveränität in der Praxis umsetzen lässt.